- RapidNova7591小时前
最近折腾了一套家里的 NAS 运维助手,暂且叫 HomeOps。机器是 GKN6000 NAS,加一台 J4125/OpenWrt 主路由,上面已经跑着 Gitea、Nextcloud、Vaultwarden、Home Assistant 等服务。
起因很简单:出了安全事件,希望有人早点发现;软件该不该更新,希望有人先查清楚兼容和迁移;服务凌晨挂了,也不想只收到一句“异常/已恢复”,还得自己翻半天日志。
最开始想在两台机器上各塞一个 Agent,让它们互相检查。后来拆成了两层:Go 程序持续做固定检查,出现事件再叫 Agent 分析。
现在的结构
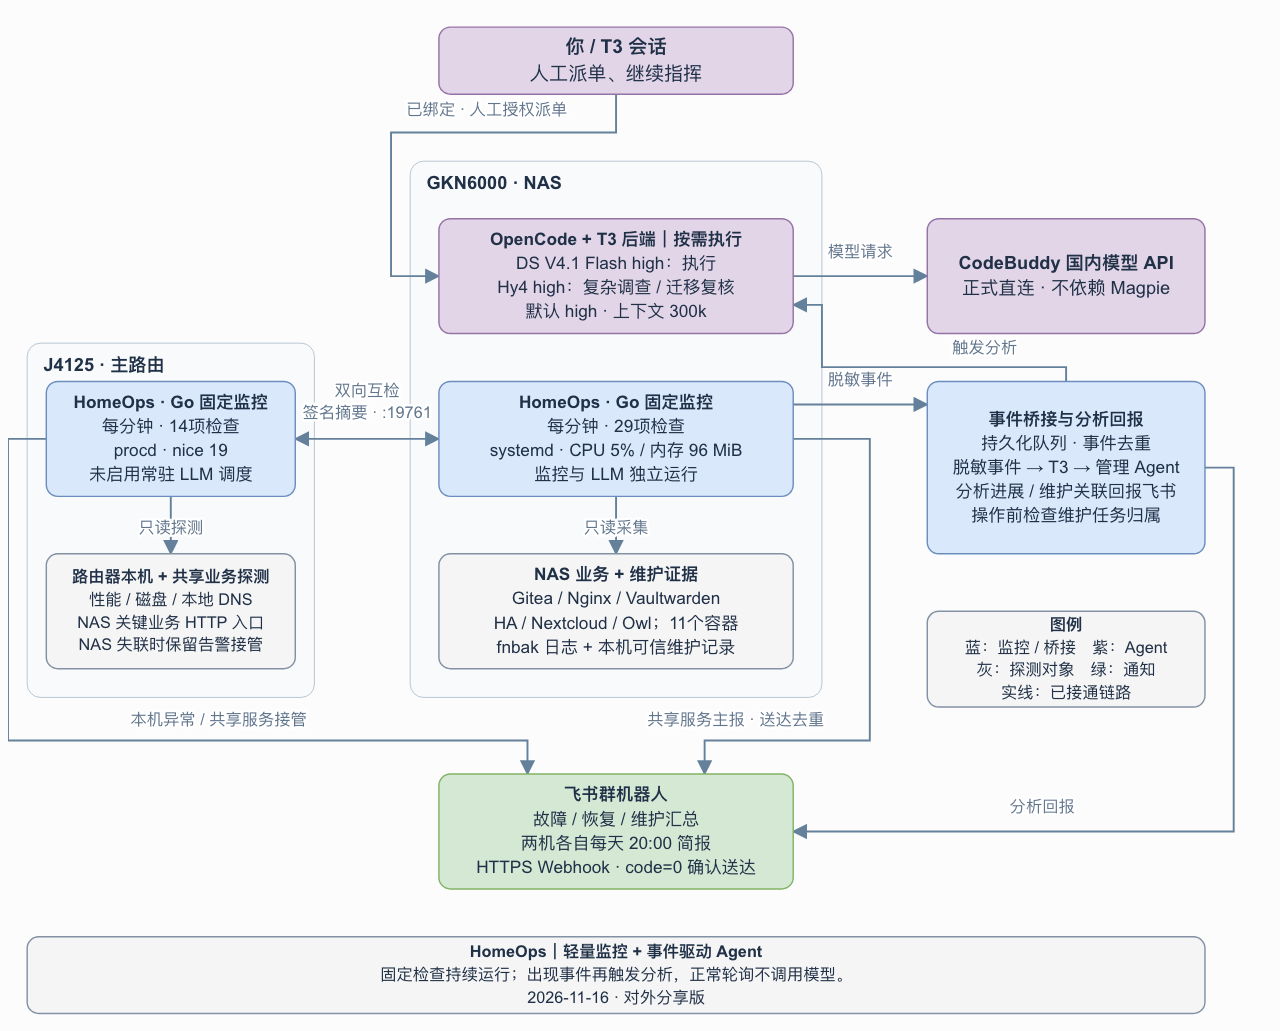
NAS:固定监控 + OpenCode 管理 Agent + T3 任务入口。
主路由:轻量固定监控,检查自己的资源、DNS,以及 NAS 的服务和监控进程。现在没在主路由上跑常驻 LLM 调度。
飞书:接收告警、恢复、备份汇总、每日简报,以及 Agent 的分析进度和结论。
模型:CodeBuddy 国内官方接口直连。日常执行用 DeepSeek V4.1 Flash,复杂安全调查、迁移及回退方案复核交给 Hy4。当前默认 high,上下文配置 300k。
T3 Code 主要用来接远程任务、保留会话上下文;真正执行工具的是 OpenCode。模型推理在云端,NAS 跑探针、执行器和工具。
为什么固定监控不用 AI
我最担心的问题是:如果 Agent 把自己所在的机器玩坏了,谁来发现?
所以两台机器各自运行独立的 Go 监控,不依赖模型、Agent 会话或我这台电脑。NAS 平时负责共享服务的主报告,路由器保留接管能力;不能因为对面的进程还活着,就永远相信它已经发出了通知。
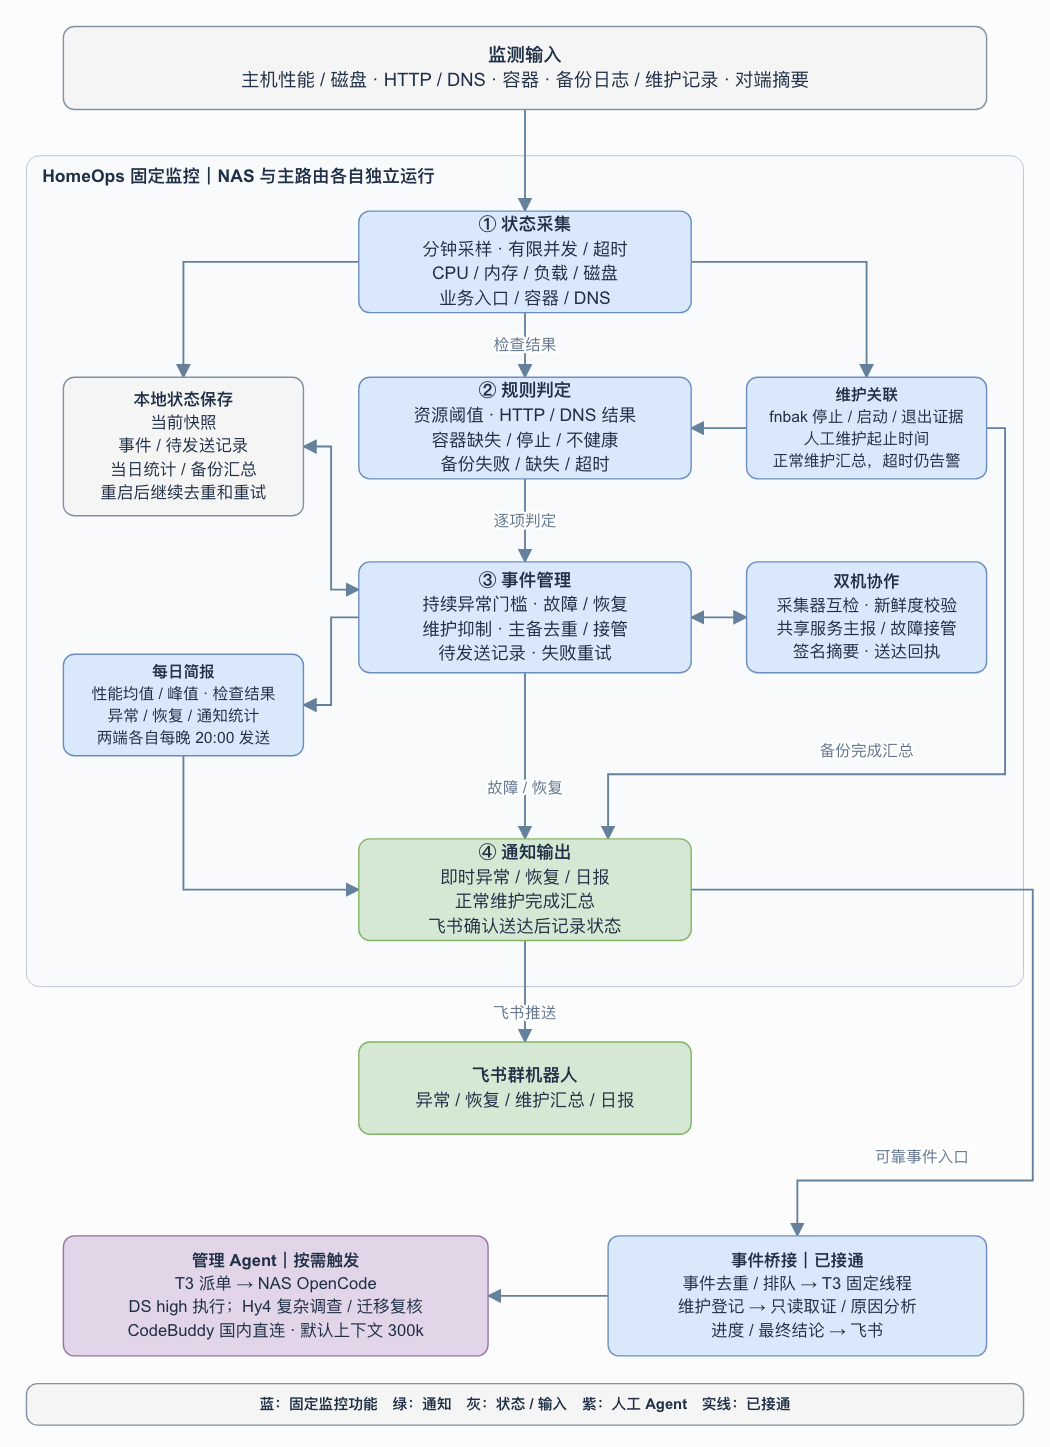
普通检查按分钟跑,覆盖内存和磁盘、业务 HTTP、DNS、预期容器是否存在/运行/健康、对端采样是否新鲜。CPU、负载等数据累计到每日简报。Nextcloud 还会看 status.php 的语义,不能随便一个 200 就算健康。
固定监控这层此前一次约 70 秒的空闲采样,两个进程的 RSS 都在十几 MiB,平均单核 CPU 约 0.03%。这个数字只对应探针,不是 Agent 执行任务时的资源占用。NAS 探针设了 5% CPU、96 MiB 内存上限;主路由保留低优先级运行。
告警之后,Agent 怎么接上
现在已经接通了这条链路:
固定探针确认事件
→ 桥接先写本地队列,再投递脱敏事件
→ T3 固定会话排队 / 去重
→ OpenCode Agent 查证据、关联维护任务
→ 飞书回报进展和结论
→ 我可以在原会话里继续指挥健康轮询不调用模型。故障和恢复带事件标识,通知失败、进程重启后继续处理。也区分“已投递”“正在分析”和“分析完成”,不把 webhook 收到请求当成 AI 已经解决问题。
飞书目前是通知出口,还没做成从群里双向控制整套系统。
踩过几个很实际的坑
- 凌晨 Gitea 异常,最后是备份主动停的
第一次收到的是两台机器分别发“异常”,过一会儿再分别发“恢复”。看起来很热闹,信息量却很少。
查完发现,每天 04:30 的一致性备份会主动停 Gitea,备份完再启动。现在读备份日志里的实际开始、停止、启动和退出结果,关联到维护窗口;正常只汇总一次,失败或超时照样告警,而不是每天固定把 04:30 静音。
顺便还踩了个解析坑:真实日志的时间戳有 CST 后缀,合成样例里没带,测试都绿了,现场却读不到周期。
成功通知最后压成了这样:
[HomeOps] NAS 备份完成
04:30:11–04:33:35,耗时3分24秒。
Gitea停服2分1秒。- 多个 Agent 会互相“帮倒忙”
一个任务正在迁移数据库,另一个告警 Agent 看到服务停着,很容易热心地去拉起它。
后来加了一个按检查项登记的维护归属:哪个任务正在动什么服务,操作前先查;同一检查被其他任务持有就停止写操作,不能到期了直接抢。分析 Agent 先关联负责的维护任务,再说明这是预期停机还是额外故障。
这比在每个提示词里重复一句“谨慎操作”具体得多。
- 升级的重点经常是迁移和回退
我让 Agent 做 Gitea 升级时,花时间的主要是配置弃用项、数据库迁移、一致性备份、隔离恢复和回退预演,以及升级后的真实 Git 读写验收。拉个新镜像反而是最简单的一步。
所以复杂调查、迁移方案和执行分开处理。不能因为一个健康接口恢复了,就把整个迁移当验收完成。
- 提示词规则不是权限隔离
隔离工作区和宿主管理实例分开。管理 Agent 现在默认普通用户,必要时可 sudo;有能力管理整机,也意味着权限很大。维护登记只是协作约束,不是一个能拦截所有 shell 的安全沙箱。
我更愿意让固定探针保持独立,把授权、备份、操作记录和回退过程做实,而不是给它一句“你是专业运维专家”就放心睡觉。
还在继续补的部分
目前已经有固定监控、双机互检、维护关联、事件到 Agent 的分析回报,以及人工继续下指令的入口。完整入侵检测、安全公告/漏洞的持续跟踪、SMART 和恢复演练还没做齐。两台机器同处家里,断网或停电也仍有盲区,后面还需要外部探测。
这两天做下来,最费精力的不是选哪个模型,而是让通知有用、任务不互相打架、出问题时能知道谁正在做什么。
有在家里把 Agent 接到 NAS / 路由器做运维的 V 友吗?你们把哪些动作开放给它了,哪些还坚持手动?
 主楼
- LuckyLynx7801小时前
这个架构设计很实用,尤其是固定监控和AI分离的思路,既保证了系统稳定性又提升了问题处理效率。
- HappyRaven321小时前
我线上就这样搞过,探针先过个基础筛,再让AI接手分析,避免误报和资源浪费。
- HappyDeer69956分钟前
固定监控里的"对端采样是否新鲜"具体是怎么检查的?是定时ping还是检查端口连通性?
- AmberNova21046分钟前
这架构设计挺有意思,AI接管运维但保留固定监控避免单点故障,思路很稳。
- BrightFox48339分钟前
这套系统看起来挺酷,但AI接口直连国内真的稳定吗?